 点击放大
研究背景 · ABSTRACT
随着自然语言处理技术的不断发展,预训练语言模型(PLMs)已在多种任务中取得显著成果。然而,在新闻文本分类这一具体场景中,PLMs仍面临两方面挑战:一是任务针对性不足,即通用预训练模型难以充分适配新闻分类任务的特定需求;二是标注数据有限,制约了模型性能的进一步提升。
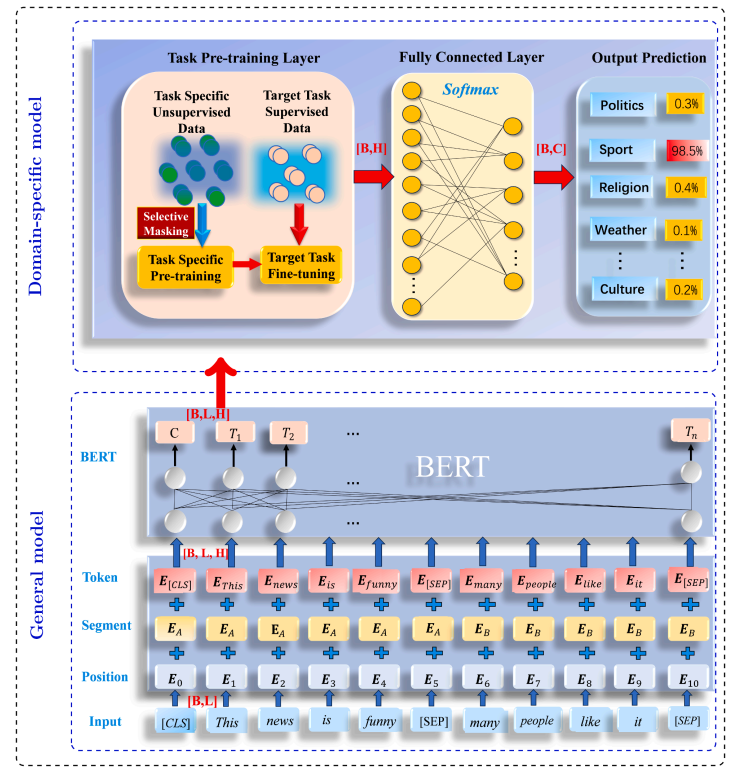
针对上述问题,本文提出了一种增强型新闻分类框架,其核心思路是在标准预训练与微调阶段之间引入一个面向领域的中间预训练阶段。该阶段利用中等规模的无监督新闻数据集,帮助模型获取领域特定知识;同时采用自适应选择性掩码机制,动态遮蔽关键术语,使模型能够更好地捕捉与任务相关的信息。此外,本文还提出了错误标注样本清洗与训练过程重加权的方法,以进一步提升分类性能。
 点击放大
研究成果 · CONTRIBUTIONS
本研究主要成果包括:
贡献可归纳为以下三点:
(1)提出了一种改进的分类框架,将通用预训练(GenePM)与任务特定预训练(TaskSPT)相结合。其中,TaskSPT利用领域特定的无监督数据进行自适应选择性掩码,并通过带有Softmax的全连接层生成最终分类结果。
(2)在微调阶段,对每一层采用不同的学习率,以保留预训练特征;同时采用Adam优化器,并结合预热与线性衰减策略,以提升收敛速度和训练稳定性。
(3)识别并移除下游监督学习任务中可能存在的错误标签,并应用重加权与重训练策略,以提升标签质量和整体模型的鲁棒性。